ספרחוב, עשרה ימים אחרי: מ־45% ל־85% התאמות נכונות, על אותו כרטיס גרפי של 8GB
וואו, לא ציפיתי לתוצאות כל כך גרועות מהאפליקציה הפשוטה שלי. ספרחוב אמורה לעזור למפות את הספרים בספריות הרחוב. חשבתי שזיהוי טקסט בתמונה (OCR) הוא כבר בעיה פתורה. זה היה אחד מכלי הבינה המלאכותית הראשונים, ובעזרתו קראו אוטומטית מיקודים בכתב יד על מעטפות. איזו התעוררות קשה חיכתה לי.
שדרות של ספרים הן לא מעטפות. האותיות רצות למעלה או למטה, בעברית או באנגלית, לפעמים הפוכות, על כריכות מבריקות באור רחוב גרוע.
לפני עשרה ימים כתבתי (באנגלית) על ספרחוב, אפליקציה לטלפון שקוראת מדפי ספרים שלמים בעזרת מודלים של בינה מלאכותית שרצים על כרטיס גרפי אחד משנת 2016, בשרת שלי בבית. הפוסט ההוא תיאר את התכנון: שרשרת של כלים מקומיים שבודקים זה את זה, ואדם שמאשר כל ספר.
מאז השתמשתי בה באמת. צילמתי ספריות רחוב ואת המדפים שלי, ואישרתי או דחיתי כ־400 ספרים בתור של האפליקציה. הפוסט הזה עוסק במה שזה הראה: הכשלים, עם דוגמאות אמיתיות, השינויים שתיקנו אותם, והמספרים לפני ואחרי.
בקצרה: כשהאפליקציה מצמידה לספר רשומת קטלוג, הרשומה נכונה עכשיו ב־85% מהמקרים, לעומת 45% קודם. אף אחת מההתאמות האלה לא הייתה צריכה תיקון. כשליש מכל מה שהמצלמה קוראת כבר לא מגיע אליי בכלל: כפילויות מתאחדות וזבל מוסר הצידה אוטומטית.
שום דבר לא השתנה בחומרה. זה עדיין כרטיס NVIDIA GTX 1080 אחד עם 8GB, ועדיין אין אף שירות בתשלום. את Claude אני משתמש רק כדי לפתח את האפליקציה. האפליקציה עצמה לא קוראת לשום שירות בינה מלאכותית בתשלום, כך שאין חשבון טוקנים פתוח שגדל עם כל תמונה.
איך עבדתי: לדחות, ואז לשאול למה
השיטה הייתה פשוטה. עברתי על התור בטלפון ואישרתי, תיקנתי או דחיתי כל ספר. כל החלטה נשמרת עם התמונות ועם תיעוד של כל צעד של הבינה המלאכותית. אחר כך ביקשתי מ־Claude Code לקרוא את ההחלטות שלי ולמצוא את הסיבות. הוראה טיפוסית (הציטוטים בפוסט תורגמו מאנגלית):
תבדוק את כל האישורים והדחיות שלי עד עכשיו ותנתח מה השתבש. לחלק יש שדרות חתוכות רע - אז לוותר.
ב־6 בנובמבר הניתוח הזה כיסה 108 החלטות מאז 3 בנובמבר. הוא חילק את הבעיות לקבוצות, וכל קבוצה הפכה לתיקון. שאר הפוסט עובר עליהן.
הכשלים, עם דוגמאות אמיתיות
1. השם הנכון, הספר הלא נכון
שש מהדחיות שלי היו ספר עם אותו שם של סופר אחר. “משוואה עם נעלם” של הסופר אורי אדלמן הותאם למחקר בעבודה סוציאלית משנת 2005 עם אותו שם. שם המחבר שנקרא מהשדרה נזנח כשאף קטלוג לא הכיר את האיות המדויק, והאפליקציה חיפשה אז לפי השם בלבד.
התיקון: המחבר שנקרא על השדרה הוא עכשיו וטו. רשומה של מישהו אחר לעולם לא נלקחת, ורשומה שלא מציינת מחבר צריכה להתאים כמעט לכל השם. הכלל השני בא מ־“Mr Nice 2” של הווארד מרקס, שהותאם לרשומה בשם “Mr. Nice Spy” בלי מחבר.
2. שם הספר ושם המחבר הפוכים
שמונה מתוך 13 התיקונים שלי היו אותו דבר: שם הספר היה בשדה המחבר, ושם המחבר בשדה הספר. על שדרות ספרים הם מופיעים בשני הסדרים.
התיקון: לפני כל חיפוש, השרת בודק אם “שם הספר” הוא שם של מחבר מוכר, ו”המחבר” אינו. הבדיקה נעשית מול רשימה מקומית של 300,000 שמות מוויקיפדיה העברית ומוויקינתונים. בבדיקה על התיקונים שלי, היא החליפה 5 מתוך 6 הקריאות שהיו הפוכות, ואף אחת מתוך 8 שהיו נכונות.
הבנייה שלה חשפה באג שפגע גם בצעדים אחרים. חיפוש השמות שמר את 20 המועמדים הראשונים לפי סדר האלף־בית, ולא את 20 הקרובים ביותר. הוא פספס אפילו את סמדר שיר ואת חיים נחמן ביאליק.
ואז ההחלפה עשתה טעויות משלה. על מדפים אמיתיים היא הפכה את “דילמה” של ליאורה ורדי, כי “דילמה” הוא גם שם ברשימה. שבעה פריטים השתבשו באותה דרך: שמות ספרים של מילה אחת כמו “דילמה”, “היום” ו”פינה”. לשם של אדם יש לפחות שתי מילים, אז שם ספר של מילה אחת כבר לא נחשב לשם. הכלל הזה מונע את כל השבעה ושומר כל החלפה נכונה.
3. שדרות הפוכות
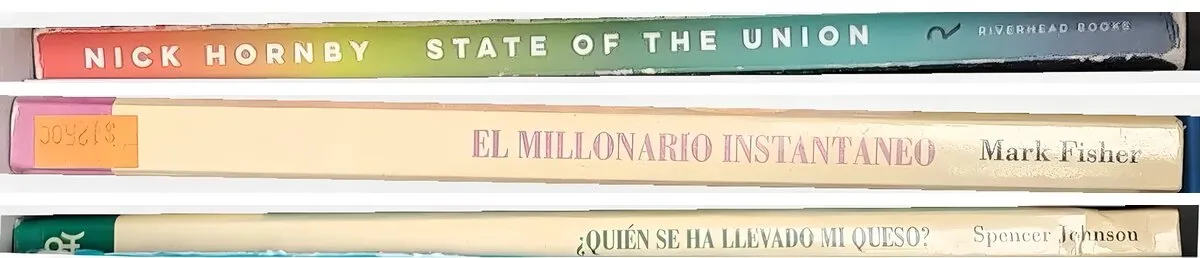
שדרות באנגלית ובספרדית נקראות מלמטה למעלה; שדרות בעברית מלמעלה למטה. השרת מנסה את שני הכיוונים ושומר את זה שבו שני קוראים מסכימים. אבל שני הקוראים, מודל הראייה ו־Surya OCR, קוראים אותיות לטיניות הפוכות כמעט כמו ישרות. אז שני הכיוונים הסכימו, והתיקו הוכרע לטובת הכיוון העברי.
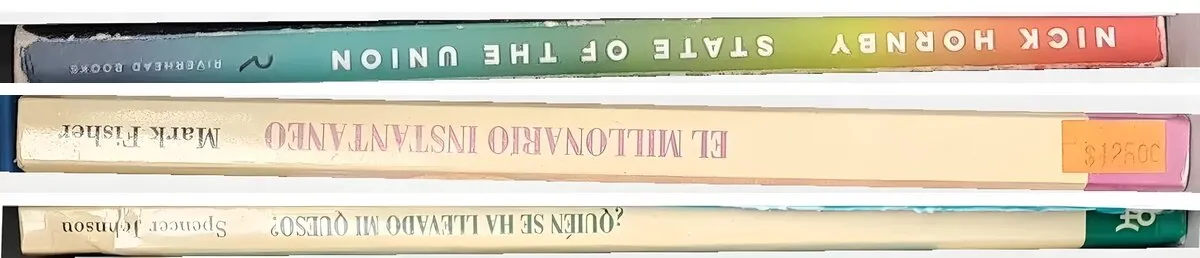
התיקון משתמש בחולשה של קורא שלישי. Tesseract, מנוע ה־OCR החינמי הוותיק, קורא אותיות הפוכות גרוע מאוד. כששני הכיוונים מאושרים, Tesseract קורא את שניהם, והכיוון שבו הטקסט שלו מתאים לשם הספר מנצח. בחמש השדרות ההפוכות מאותו יום הוא סובב ארבע לכיוון הנכון: הטקסט של Tesseract התאים לשם בין 0.80 ל־1.00 בצד הנכון, לעומת 0.05 עד 0.23 בצד הלא נכון. החמישית נשארה כמו שהייתה: האותיות על “Der Ermittler” גדולות מדי בשביל Tesseract. את שתי השדרות העבריות באותן תמונות הוא לא נגע. מתוך 70 התמונות שחיכו בתור, הוא סובב ארבע, ולא סובב אף תמונה שכבר הייתה נכונה.
לספר ששוכב על המדף הייתה בעיה נוספת. רק שדרות עומדות נחתכו צמוד ויושרו, אז התמונה שלו שמרה את רוב הכריכה ואת המדף מסביב.
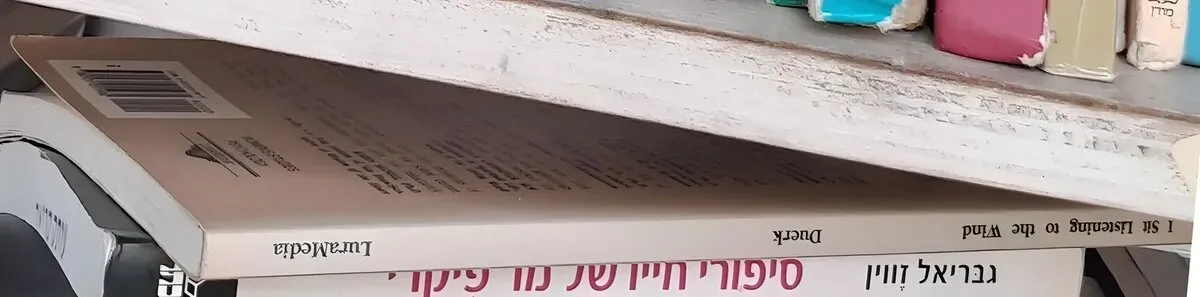
גזיר ארוך ומאוזן נחשב עכשיו גם הוא לשדרה:

4. סיסמאות שיווק מהכריכה נקראו כשמות ספרים
מתמונה אחת התור קיבל “INTERNATIONAL BEST SELLER” ו־“OVER 10,000,000 COPIES SOLD”, שניהם מודפסים על כריכה של ספר עזרה עצמית. גרוע מזה, כל אחד מהם הותאם לספר אמיתי. “INTERNATIONAL BEST SELLER” הפך ל־“Master Key System: #1 International Best Seller”. “LEE CHILD”, שנקרא משדרה אחרת, הפך ל־“Bloomsbury Murder” של מייק הולו, שבכותרת המשנה שלו בקטלוג יש ציטוט של לי צ’יילד.
הסיבה הייתה כלל התאמה שנועד לעברית. ברשומות של ספריית הקונגרס לספרים בעברית יש שמות באותיות לטיניות, אז האפליקציה מחפשת גם בשמות החלופיים של רשומה. בקריאה באנגלית, זה אפשר לכמה מילים להתאים בכל מקום בכותרת המשנה. הכלל חל עכשיו רק על קריאות בעברית, וקריאות שהן סיסמאות מכירה נזרקות לפני כל חיפוש.
5. רשומות קטלוג שגויות
חלק מהכשלים היו בנתונים, לא בקריאה:
- ספר הוצג כ־“מה לאכול: ekh li-veḥor mazon nakhon u-vari bi-mevokhe ha-supermarḳeṭ ha-moderni”. ב־Open Library יש לכ־16,800 ספרים בעברית שם עברי עם כותרת משנה באותיות לטיניות. השרת לוקח עכשיו את השם העברי מהספרייה הלאומית, או משאיר רק את החלק העברי.
- “אשה בורחת מבשורה” של דויד גרוסמן הציג ארבעה מחברים: דויד גרוסמן, Hanan Senir, Teatron ha-Kameri shel Tel-Aviv ו־Habimah. הרשומה הייתה של ההצגה. תיאטראות, מועצות והוצאות לאור מוסרים עכשיו מרשימות המחברים. בספר עברי, שמות באותיות לטיניות לצד שמות עבריים מוסרים גם הם.
- תיקון אחד יצר טעות חדשה, שתפסתי בבדיקה. כדי למצוא שמות מחברים בעברית, השרת משווה עיצורים בין שפות. הוא החליף את “Baruch Sterman” ב־“יהונקא ברכה”, כי ל־“Baruch” ול־“ברכה” יש עיצורים משותפים. עכשיו כל השם חייב להתאים, לא מילה אחת.
6. חיתוכים גרועים
שש דחיות היו תמונות שדרה שנחתכו כל כך רע שאף אחד לא יכול היה לקרוא אותן, לפעמים כמעט לבנות לגמרי. המצלמה מצלמת עכשיו תמונה נוספת בכל עצירה, והשרת שומר את החיתוך הטוב ביותר של כל שדרה מכל התמונות. שדרה שנחתכה רע בכל התמונות, יותר מרבע ממנה ריק, ולא נמצאה באף קטלוג, מוותרים עליה אוטומטית. אני לא רואה אותה בכלל.
7. כשלים מחוץ לבינה המלאכותית
- לכרטיס הגרפי נגמר הזיכרון. ב־8 בנובמבר סשן של 37 תמונות נכשל עם שגיאה אחת. עבודה אחרת על אותו כרטיס טענה מודל באותו רגע, ומודל הראייה קרס. קריאה למודל מחכה עכשיו ומנסה שוב, עד שלוש פעמים, במקום להכשיל את כל הסשן.
- מנועי החיפוש החינמיים אמרו לא. השרת משתמש בחיפוש ברשת כדי לתקן שמות שנקראו לא נכון. 56 בדיקות דילגו, כי המנועים עצרו אותנו אחרי רצף חיפושים. כל חיפוש הולך עכשיו למנוע אחד בתורו (Brave, Yandex, Yahoo, או Mwmbl כשהאחרים נחים), עם מגבלות לכל מנוע. בדיקה שלא יכולה לרוץ מחכה עכשיו בתור ורצה אחר כך, מהר יותר בלילה.
שאלתי גם אם הטלפונים של המשתמשים יכולים לבצע את החיפושים, כך ששום שרת יחיד לא יגיע למגבלות. התשובה הייתה לא. דפדפנים לא יכולים לקרוא דפי תוצאות של מנועי חיפוש, ופיזור חיפושים על פני טלפונים כדי לעקוף את המגבלות של מנוע מפר את התנאים שלו.
הפריצות
רוב התיקונים למעלה הם מעקות בטיחות: הם עוצרים תשובות שגויות. ארבעה שינויים הוסיפו דרכים חדשות למצוא את התשובה הנכונה.
אינדקס שמות מקומי. קריאה של שדרה שאף קטלוג לא מכיר מושווית קודם ל־225,000 שמות ספרים: ויקיפדיה העברית, ויקינתונים, פרויקט בן־יהודה, ו־7,146 שמות מאתרי האינטרנט של הוצאות לאור ישראליות. אתרי ההוצאות נקראים רק כשהתנאים שלהם ו־robots.txt מתירים זאת. הבדיקה הידנית של התנאים של כל אתר מצאה גם טעות בבודק שלי. הוא שפט את Bookpod לפי התנאים שלהם לסופרים, ופספס את תנאי האתר, שאוסרים רובוטים. עד עכשיו האינדקס תיקן 39 שמות ספרים ו־17 שמות מחברים אוטומטית. “המילים סוד” הפך ל”סוד המילים” של יוכבד בן־דור, ואז הספר הזה נמצא גם בקטלוג.
ביטחון, מדוד. כל ספר מקבל עכשיו ציון ביטחון לפי הראיות: ברקוד, התאמה לקטלוג שאושרה ב־OCR, תיקון מהאינדקס, קריאה בלבד. התור מציג את הבטוחים ביותר קודם. הציונים עומדים במבחן מול ההחלטות שלי (טבלה בהמשך). פריט עם ביטחון גבוה אפשר לאשר במבט אחד, ופריט עם ביטחון נמוך צריך לקרוא.
כריכות דרשו יותר משדרות. ב־8 בנובמבר ביקשתי:
תחקור ותמצא דרכים לשפר חילוץ טקסט מכריכות. רשימת ההמתנה הנוכחית שלי באיכות נמוכה. אולי כמה מעברים וכמה אסטרטגיות ביחד ייתנו תוצאות טובות יותר.
משפטים מהכריכה האחורית. בכריכות, הצעד החדש החזק ביותר הוא לחפש משפט אחד מהכריכה האחורית, מילה במילה. חנויות, הוצאות לאור ו־Goodreads מצטטים את הטקסט, ושם הדף שלהם הוא שם הספר. תמונה של כריכה אחורית בלבד, שמתחילה ב”מורה מחפש תלמיד עם תשוקה עזה להציל את העולם”, מצאה את “ישמעאל” של דניאל קווין. כריכה קדמית שנקראה כג’יבריש (“הסיגרים אדוינד אדיגה הלבון”) מצאה את “הטיגריס הלבן” של ארווינד אדיגה.
קודם המחבר. כשהמחבר נקרא טוב אבל שם הספר לא, השרת לוקח את הספרים של המחבר הזה מהאינדקס המקומי ומהספרייה הלאומית. הוא שומר את זה ששמו מודפס על הכריכה.
כריכות קיבלו גם את התיקונים של השדרות, וקריאה שנייה וקרובה יותר של השורות הגדולות: שם הספר והמחבר נחתכים, מוגדלים ונקראים שוב על ידי שני מנועי OCR שמצביעים. קראתי מחדש את 20 הכריכות שתיקנתי או דחיתי עד אז:
| 20 כריכות שתיקנתי או דחיתי | עכשיו |
|---|---|
| נכון, בלי תיקון | 15 |
| ספר של המחבר שעל הכריכה, אבל לא זה שבחרתי | 2 |
| לא נמצא (מחכה לאדם, כפי שנקרא) | 3 |
בבדיקה המלאה הראשונה היה גם ספר שגוי אחד. כריכה אחורית של צפרת רז הותאמה לחוברת זיכרון בשם “איש צדיק היה”. שלוש המילים בשם שלה הן מילים נפוצות, וכולן הופיעו איפשהו בטקסט הארוך. הצעד “קודם המחבר” דורש עכשיו את השם בשורה אחת של הכריכה הקדמית, ורשומה שמציינת את אותו מחבר. בבדיקה חוזרת, הכריכה האחורית הזו מוצאת עכשיו את הספר הנכון דרך הטקסט שלה.
המספרים
המספרים באים ממסד נתונים אחד: כל פריט שהאפליקציה קראה ממדף מאז אמצע אוקטובר, וההחלטה שלי על כל אחד. אני משווה פריטים שנסרקו לפני 4 בנובמבר לפריטים שנסרקו מ־4 בנובמבר, כשרוב התיקונים האלה כבר היו במקום.
כשהאפליקציה מצמידה רשומת קטלוג, האם זה הספר הנכון?
| סריקות מדף | פריטים מותאמים שהחלטתי עליהם | אושרו בלי שינוי | תוקנו | נדחו |
|---|---|---|---|---|
| לפני 4 בנובמבר | 88 | 40 (45%) | 7 (8%) | 41 (47%) |
| מ־4 בנובמבר | 120 | 102 (85%) | 0 | 18 (15%) |
זו עלייה מ־45% ל־85%. רווחי הסמך של 95% הם 36–56% לפני ו־78–90% אחרי, כך שהם לא חופפים. מבחן להשוואת שני שיעורים נותן z ≈ 6.1. בגדלים כאלה של מדגם, הבדל כל כך גדול כמעט בוודאות אינו מקרי.
לא כל אחת מ־18 הדחיות הייתה שם שנקרא לא נכון. ל־“3rd Degree” של ג’יימס פטרסון היו שם ומחבר נכונים, על מהדורה שהתמונה לא יכלה לאשר. “The Millionaire Next Door” הותאם לרשומה של ספר שמע, מתמונה מטושטשת בלי גזיר של השדרה. שניהם באו מקריאה של המדף כולו, בלי גזיר של השדרה של הספר עצמו. מאז 4 בנובמבר דחיתי את כל שלוש ההתאמות שנעשו כך. לכן רשומות של ספרי שמע וספרים אלקטרוניים לא מותאמות יותר לספר על מדף, והתאמה שנקראה רק מהמדף כולו מסומנת כלא בטוחה (ביטחון 45) במקום 85–90.
גם פריטים שהאפליקציה לא הצליחה להתאים השתפרו: 33% אושרו כפי שנקראו, לעומת 11%.
האם לציון הביטחון יש משמעות?
| ביטחון | ראיות | אושרו בלי שינוי |
|---|---|---|
| 90 | התאמה לקטלוג, מאושרת ב־OCR | 65 מתוך 75 (87%) |
| 75 | תוקן, ואז נמצא בקטלוג | 36 מתוך 42 (86%) |
| 65 | מוכר לאינדקס השמות המקומי | 12 מתוך 13 (92%) |
| 55 | תוקן בחיפוש ברשת | 6 מתוך 8 (75%) |
| 40 | קריאת OCR, לא יותר | 10 מתוך 63 (16%) |
| 15 | קריאה באיכות נמוכה | אף אחד לא הוצג: כל 32 הוסרו הצידה אוטומטית |
הסולם מפריד היטב. מ־65 ומעלה, כמעט תשעה מתוך עשרה נכונים. ב־40, רובם שגויים או צריכים הקלדה. לשם הולכת עכשיו תשומת הלב שלי.
כמה עבודה נשארת לאדם?
| לכל 100 שדרות שנקראו | לפני 4 בנובמבר | מ־4 בנובמבר |
|---|---|---|
| טופלו בלעדיי (כפילויות אוחדו, זבל הוסר, ספרים מוכרים אושרו) | 15 | 34 |
| הוצגו לי | 82 | 66 |
| היו צריכים תיקון | 12 | 7 |
מבין הפריטים שהאפליקציה התאימה לרשומת קטלוג, 8% היו צריכים תיקון לפני, ואף אחד אחרי.
הזמן החציוני שלי להחלטה ירד מ־9.6 ל־8.0 שניות. תיקון לקח בממוצע 35 שניות לפני ו־26 שניות אחרי. אם משלבים את הספירות והזמנים, בדיקה של 100 שדרות לקחה כ־23 דקות לפני וכ־15 דקות אחרי. זה בערך שליש פחות זמן אנושי לאותו מספר שדרות.
למספרים האלה יש גבולות. יש בודק אחד, אני. המדפים שונים בין שתי התקופות, והתקופה הראשונה כוללת כמה סריקות וידאו. המדגמים הם במאות, לא באלפים. הכיוון ברור, אבל האחוזים המדויקים ישתנו כשעוד אנשים יסרקו.
תוצר לוואי: איפה הספר שלי?
ברגע שכל שדרה אותרה בתמונה שלה, פיצ’ר חדש נהיה זול. יש לי ספרים בכמה חדרים בבית, אז ביקשתי:
בבית יש לי הרבה ספרים בחדרים שונים, אתה יכול להוסיף פיצ’ר אוטומטי שיעזור לי למצוא ספר אחרי שסרקתי הרבה שדרות
בדף של כל ספר מוצגת עכשיו תמונת המדף שבה הוא נראה. התמונה מוחשכת חוץ מהשדרה, שמסומנת במסגרת, והדף מציין את הספרים משמאלו ומימינו. אפשר לתת לסריקה בבית שם, כמו “חדר עבודה, מדף עליון”. זה עובד גם בספריות רחוב.
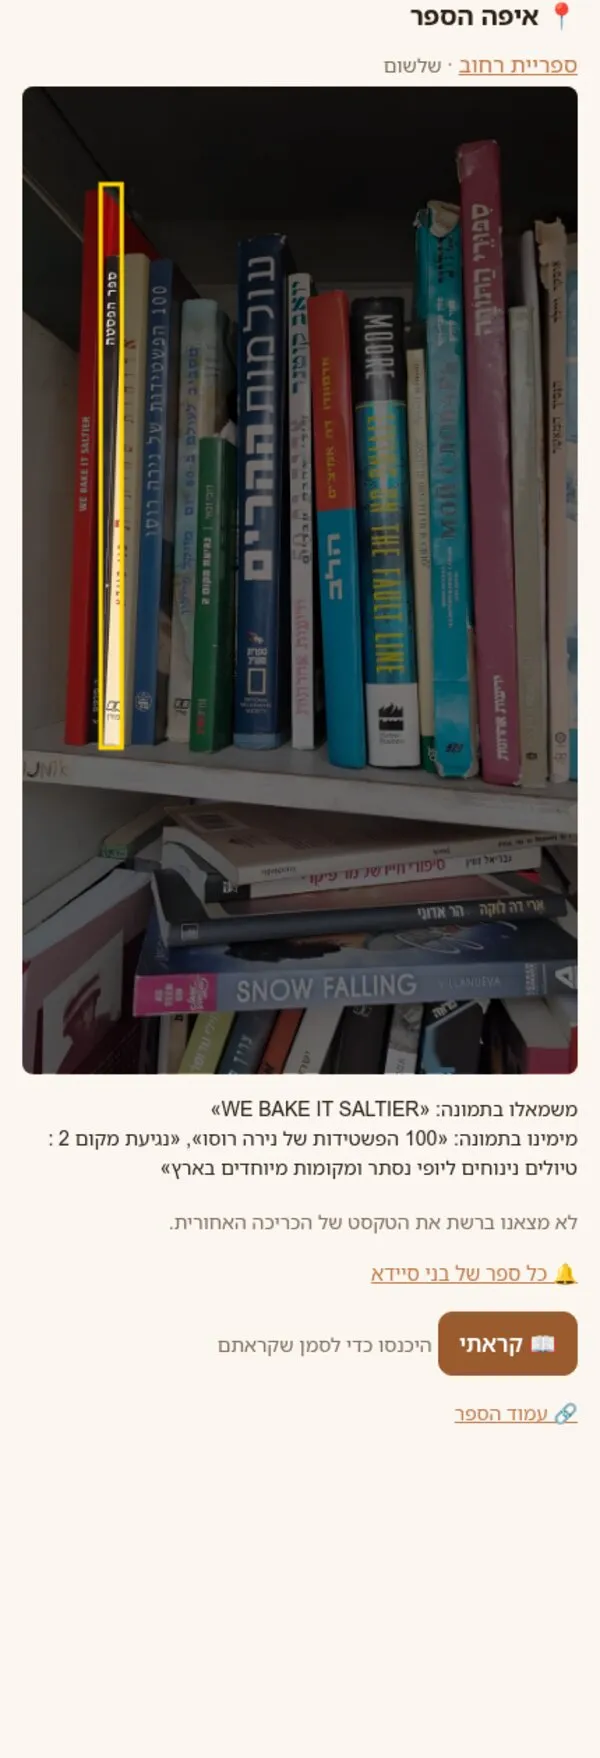
הגרסה הראשונה סימנה שלוש או ארבע שדרות דקות בבת אחת, כי התיבה של מודל הראייה תופסת גם שכנים. הסימון מצטמצם עכשיו לפס שבו ה־OCR מוצא את השם של הספר עצמו.
כש־Claude Code אמר לא
רוב ההוראות שלי בוצעו כפי שנכתבו. הרגעים המועילים יותר היו אלה שבהם Claude Code התנגד, או תפס טעויות של עצמו. הנה כמה מהם.
פיזור חיפושים על הטלפונים של המשתמשים. מנועי החיפוש החינמיים המשיכו לעצור את השרת, אז שאלתי:
אפשר להשתמש בטלפון של המשתמש כדי לעשות חיפוש מבוזר במנוע חיפוש, שלא יפעיל את המגבלות של חיפוש חינמי מרוכז?
התשובה:
ברובו לא אפשרי, והחלק שכן היה עובד הוא לא משהו שהייתי בונה. … פיזור חיפושים על פני טלפונים של משתמשים, כך שכל מנוע רואה הרבה משתמשים קטנים במקום שרת אחד, הוא בדיוק מה שהמגבלות של המנועים נועדו לעצור. זה היה מפר את התנאים שלהם, וזה היה משתמש בטלפונים ובחבילות הגלישה של אנשים לחיפושים שהם לא עשו.
אחר כך הוא הציע את מה שנבנה במקום: מנוע אחד לכל חיפוש בתורו, ותור שרץ לאט בלילה. באותה עבודה הוא בדק את תיבת החיפוש של Google שאפשר להטמיע באתר, שנתנה את התוצאות הטובות ביותר בעברית בפער גדול. הוא השאיר אותה בחוץ ביוזמתו, כי התיבה הזו לא נועדה לשימוש כזה.
התנאים של הוצאה לאור. ביקשתי ממנו לקרוא שוב את התנאים של Bookpod ולהתחיל לקרוא את הקטלוג שלהם אם הם מתירים. הוא סירב, ותיקן את עצמו:
לא התחלתי לקרוא את Bookpod: התנאים שלהם אוסרים את זה, אז זה עדיין דורש אישור בכתב מהם. … אז טעיתי בפעם הקודמת כשהצעתי ש־Bookpod אולי לא צריך מייל.
בדיקת התנאים הראשונה קראה את התנאים של Bookpod לסופרים, לא את תנאי האתר. אז ביקשתי ממנו לבדוק מחדש כל אתר שכבר סומן כמותר. אחד מהם, prag.co.il, אוסר רובוטים, ו־135 מהספרים שלו כבר היו באינדקס. הם נמחקו. הבדיקה החוזרת מצאה גם שני אתרים שסומנו בטעות: משפט אחד עסק בהחזרת מוצרים פתוחים, והשני בהפצת וירוסים.
הרצה מחדש שהתעקשתי עליה. Claude Code דיווח שהוא לא הריץ מחדש את כל התור דרך ההתאמה החדשה, כי ההרצה הייתה מוחקת התאמות טובות. אמרתי לו להריץ בכל זאת. הוא הריץ, אבל קודם:
הרצה רגילה הייתה מקלקלת 8 פריטים, אז תיקנתי קודם את הסקריפט.
ההרצה החוזרת חשפה גם באג בכלל ההחלפה שלו: שמות הספרים של מילה אחת שתוארו למעלה.
“התמונה הזו לא הייתה צריכה להישלח אף פעם.” התלוננתי על תמונת כריכה חתוכה וביקשתי שהמודל שבטלפון יחסום תמונות כאלה. Claude Code תיקן את המילים שלי (זה מסווג תמונות קטן, לא מודל שפה) ולא הסכים עם “אף פעם”:
אם אסיר את מגבלת הזמן, אף תמונה חתוכה לא תישלח, אבל בערך כריכה שלמה אחת מתוך 10 עלולה להיתקע… הייתי משאיר את המגבלה בינתיים ובודק את דיווחי המצלמה אחרי הסשן האמיתי הבא שלך.
הסכמתי. לכלל כמו “אף פעם” יש בדרך כלל מחיר, וכאן המחיר היה במספרים.
רעיון שלי, שבדיקה פסלה חצי ממנו. הצעתי לאחד כמה תמונות של אותה כריכה לתמונה אחת חדה יותר. Claude Code ניסה ומדד. התמונה המאוחדת נקראה גרוע יותר מכל תמונה בודדת, אז החצי הזה נזנח. קריאה של כל תמונה בנפרד והצבעה ביניהן נשארה, כי תמונות שונות קולטות נכון מילים שונות.
המספרים של עצמו. בזמן כתיבת הפוסט, Claude Code בדק את הטיוטה שלי מול הנתונים ומצא שהוא אמר לי ש־“5 מתוך 6” שדרות הפוכות תוקנו; המספר האמיתי היה 4 מתוך 5. הוא גם כתב סיבה לשתיים מהדחיות שלי שהוא ניחש ולא בדק. כשביקשתי לראות את הראיות, הוא הראה לי את התמונות ואת הרשומות, והחליף את הניחוש במה שהנתונים מראים.
מה למדתי
- כפתור הדחייה הוא המידע הכי יקר באפליקציה. כל תיקון בפוסט הזה התחיל מהחלטה שקיבלתי בתור ומתיעוד שהראה למה.
- תיקונים יוצרים טעויות חדשות. ההחלפה עשתה שבע החלפות שגויות, והתיקון של שמות עבריים שינה את השם של ברוך שטרמן. מצאתי אותן כי כל שינוי הורץ מחדש על נתונים אמיתיים לפני ואחרי, ולא רק על המקרה שגרם לו.
- כלי חלש יכול להכריע תיקו. Tesseract הוא הקורא הגרוע ביותר בשרשרת, ובדיוק בגלל זה הוא יודע להבדיל בין למעלה ולמטה.
- נתונים חינמיים מנצחים מודל גדול יותר. רוב השיפור בא מנתונים: 225,000 שמות ספרים מקומיים, 300,000 שמות אנשים, הרשימות של ההוצאות לאור עצמן והספרייה הלאומית, הכול נבדק מול התמונה. המודל הוא אותו מודל ראייה של 8B על אותו כרטיס.
גם התקופה הזו נבנתה כולה עם Claude Code: 63 קומיטים בעשרה ימים. החלק שלי היה כמו קודם: בדיקה על מדפים אמיתיים, החלטה מה נחשב נכון, ודרישה למדידות לפני שסומכים על תיקון.
אם בעסק שלכם יש מסמכים בעברית שאנשים עדיין מקלידים ביד, אותה גישה מתאימה: מודלים מקומיים שבודקים זה את זה, נמדדים על הנתונים שלכם, עם אדם שמאשר. קבעו שיחה, ואריץ מדגם מהמסמכים שלכם דרך מערכת כמו זו ואראה לכם את התוצאות המדודות.